Vodič · Technical SEO
Kako pretraživači pronalaze i crawl-uju vaš veb-sajt
Pre nego što pretraživač može da razume stranicu, prvo mora da je pronađe i uspešno joj pristupi. Saznajte kako funkcionišu crawlability, robots.txt, XML sitemap, noindex i canonical signali.
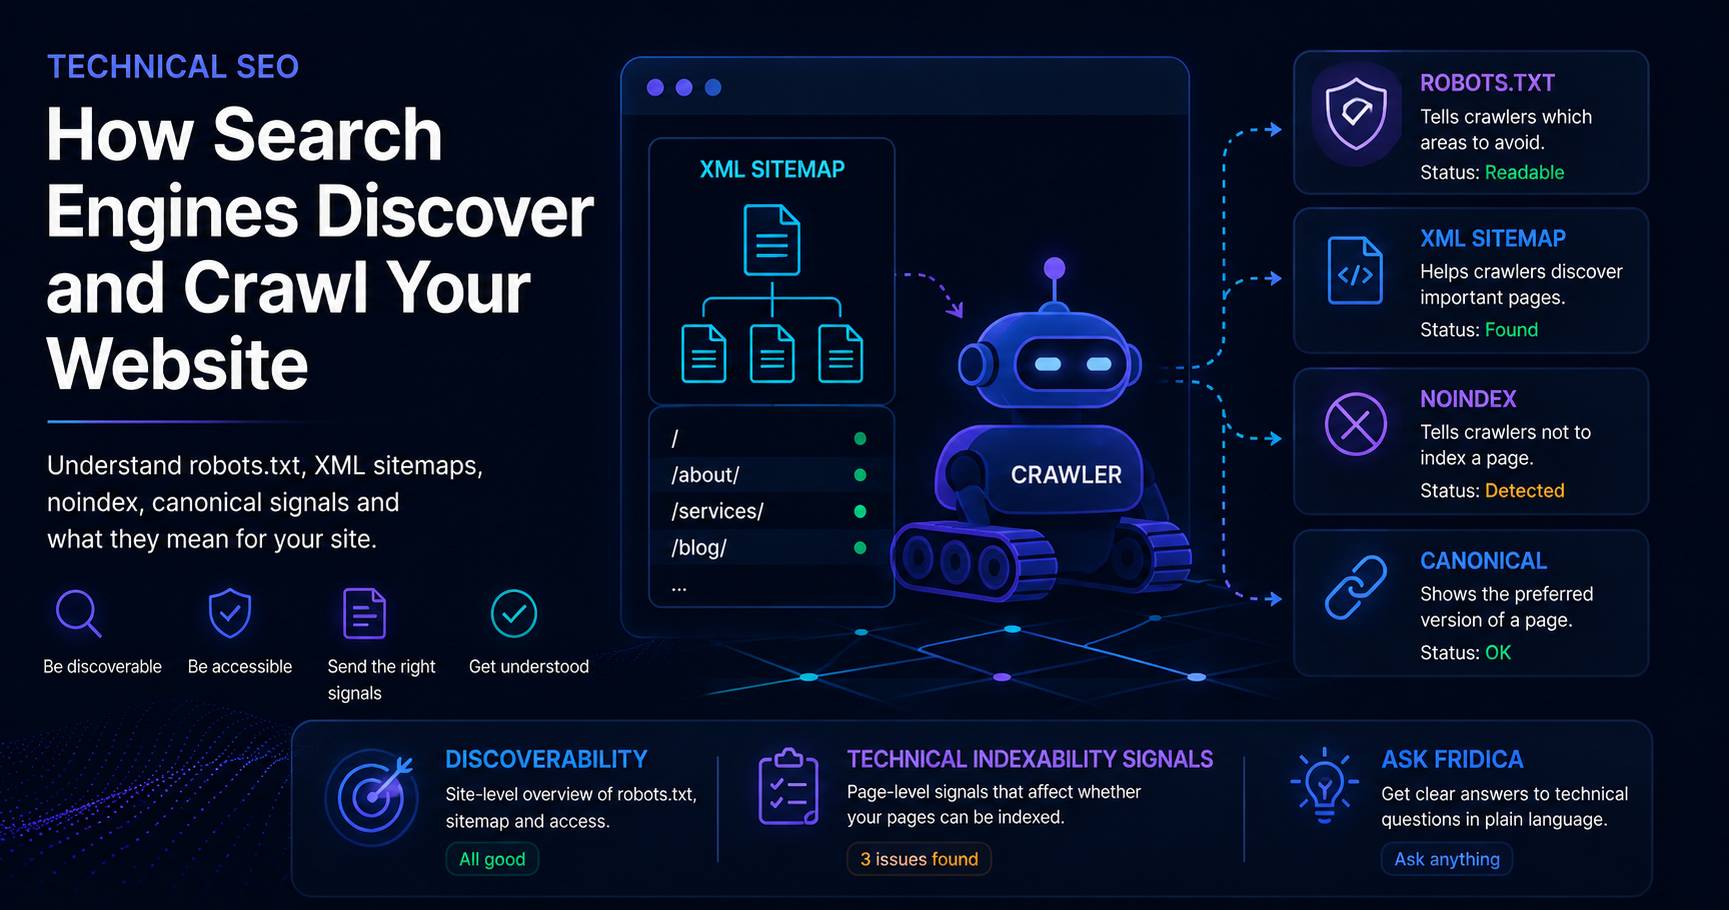
Pre nego što pretraživač može da razume stranicu, prvo mora da je pronađe i uspešno joj pristupi.
To zvuči očigledno, ali je jedan od delova SEO-a koji se najlakše previdi.
Možete napisati odličan članak, dodati korisne strukturirane podatke i pažljivo optimizovati title stranice — ali ako crawler-i ne mogu da joj pristupe ili dobiju signale koji im govore da je ne indeksiraju, ta poboljšanja možda neće imati efekat koji očekujete.
Zato Fridica ne posmatra samo title, description i heading elemente.
Postavlja i vrlo praktično pitanje:
Da li sistemi za pretragu mogu da pronađu i pristupe stranicama koje želite da vide?
Zamislite veb-sajt kao zgradu
Zamislite nekoga ko prvi put dolazi u neku zgradu.
Potrebno mu je:
- da zna kako da dođe do zgrade;
- da vrata zaista mogu da se otvore;
- da postoje oznake koje pokazuju gde sme ili ne sme da ide;
- da ima neku predstavu o tome koje prostorije postoje;
- da važna odredišta budu jasno označena.
Crawler se suočava sa iznenađujuće sličnim problemom.
Prati linkove, zahteva URL-ove, tumači tehnička uputstva i pokušava da razume koje stranice pripadaju veb-sajtu.
Fajlovi kao što su robots.txt i XML sitemap mogu pružiti dodatne smernice.
Ali nijedan od tih elemenata ne funkcioniše kao magično dugme „indeksiraj moj sajt“.
Šta je crawlability?
Crawlability opisuje da li automatizovani crawler može da zatraži i pregleda neku stranicu.
Kada Fridica auditira javni veb-sajt, ona obavlja sopstveni ograničeni crawl i posmatra šta sajt zaista vraća.
Na primer, stranica može:
- vratiti uspešan odgovor;
- preusmeriti na drugu lokaciju;
- vratiti grešku;
- sadržati
noindexdirektivu; - pružiti neočekivan canonical URL;
- biti pogođena site-wide robots pravilom.
To su uočljivi tehnički signali.
Fridica može da ih prijavi bez pretvaranja da zna šta je Google zaista uradio sa tom stranicom.
Šta je robots.txt?
Fajl robots.txt se obično nalazi u root-u veb-sajta:
https://example.com/robots.txt
On može crawler-ima pružiti uputstva o delovima sajta koje ne bi trebalo da crawl-uju.
Vrlo jednostavan primer može izgledati ovako:
User-agent: *
Disallow: /private/
Ovo crawler-ima koji odgovaraju tom pravilu govori da ne crawl-uju URL-ove unutar /private/.
Posebno važna konfiguracija je:
User-agent: *
Disallow: /
To je široko pravilo koje od odgovarajućih crawler-a traži da ne crawl-uju veb-sajt.
Ponekad je to namerno — na primer na staging sajtu.
Na javnom produkcionom sajtu, međutim, takvu konfiguraciju treba pažljivo proveriti.
Šta Fridica proverava u robots.txt fajlu
Fridica namerno zadržava ovu proveru konzervativnom.
Može da utvrdi da li je javni robots.txt fajl čitljiv i da pregleda podržane signale, kao što je jednostavna wildcard zabrana za ceo sajt.
Ne pokušava da simulira svaki mogući crawler, svaku user-agent kombinaciju ili svaku složenu robots politiku.
To je važna dizajnerska odluka.
Ako Fridica nema dovoljno determinističkih dokaza da nešto proglasi problemom, ne treba da ga izmišlja.
Šta je XML sitemap?
XML sitemap je mašinski čitljiva lista URL-ova koje veb-sajt želi da izloži radi lakšeg otkrivanja.
Jednostavan sitemap može izgledati ovako:
<urlset>
    <url>
        <loc>https://example.com/</loc>
    </url>
    <url>
        <loc>https://example.com/about/</loc>
    </url>
</urlset>
Veći sajtovi mogu koristiti sitemap index koji pokazuje ka više zasebnih sitemap fajlova.
Sitemap može pomoći da URL-ovi budu otkriveni, ali njegovo postojanje ne garantuje da će svaka navedena stranica biti indeksirana.
Isto tako, sajt bez sitemap-a nije automatski neispravan.
Ta razlika je ugrađena u način na koji Fridica ocenjuje rezultate.
Kako Fridica tretira postojanje sitemap-a
Fridica ne dodeljuje veštačke SEO poene samo zato što sitemap postoji.
Umesto toga, traži konkretne uočljive probleme.
Na primer, Fridica može proveriti da li:
- sitemap može biti pronađen;
- deklarisani sitemap može biti preuzet;
- preuzeti XML ima upotrebljivu strukturu;
- unosi sadrže neispravne URL-ove;
- URL-ovi neočekivano vode na drugi host;
- postoje duplirani unosi;
- je sigurnosno ograničenje sprečilo pregled većeg broja podataka.
Važna ideja je jednostavna:
Samo postojanje nije isto što i kvalitet.
Šta Discoverability znači u Fridici?
U Full Website Audit-u, Fridica prikazuje posebnu sekciju Discoverability.
Ona namerno nije još jedan score.
Sažima korisne informacije na nivou sajta, kao što su:
- da li je
robots.txtbio dostupan; - da li je sitemap pronađen;
- koliko URL-ova je deklarisano u pregledanim sitemap podacima;
- da li postoje konkretni problemi koje treba proveriti.
Na primer, možete videti:
robots.txt: Readable · Sitemap: Found
To je koristan dokaz o javnoj tehničkoj postavci sajta.
To nije tvrdnja da je svaka stranica indeksirana.
A šta su Technical Indexability Signals?
Ova sekcija posmatra signale direktno primećene na stranicama koje je Fridica uspešno pregledala.
To može uključivati:
- uspešne konačne odgovore stranica;
- otkrivene
noindexdirektive; - nedostajuće ili problematične canonical signale;
- podržanu wildcard robots blokadu;
X-Robots-Tagdirektive kada su bile uhvaćene.
Posmatrajte ovu sekciju kao tehnički zdravstveni pregled stranica koje je Fridica zaista videla.
Šta znači noindex?
Stranica može sadržati robots direktivu kao što je:
<meta name="robots" content="noindex">
Server može poslati sličnu instrukciju i preko X-Robots-Tag response header-a.
Kada Fridica otkrije podržani noindex signal, prijavljuje ga kao upozorenje za indexability.
To ne znači da je direktiva nužno greška.
Možda namerno želite da stranice kao što su interni rezultati pretrage, privatne pomoćne stranice ili određene arhive budu isključene iz pretrage.
Važno pitanje je:
Da li je noindex direktiva namerna?
Kakve veze canonical URL ima sa ovim?
Canonical URL pomaže da se identifikuje preferirana javna verzija stranice kada više URL-ova može predstavljati sličan ili ekvivalentan sadržaj.
Na primer:
<link rel="canonical" href="https://example.com/preferred-page/">
Fridica može da pregleda canonical signal koji stranica pruža i prijavi probleme kada očekivani signal nedostaje ili je problematičan.
I ovde Fridica procenjuje markup koji može da vidi.
Ne tvrdi da zna koji URL je pretraživač na kraju izabrao za indeksiranje.
Crawl-ovana stranica nije isto što i indeksirana stranica
Ovu razliku vredi zapamtiti.
To što je crawler uspešno pristupio stranici ne dokazuje da je ona indeksirana.
Isto tako, činjenica da sitemap sadrži URL ne dokazuje da se taj URL pojavljuje u rezultatima pretrage.
Zato Fridica izbegava da kaže:
„Ova stranica je indeksirana.“
Umesto toga, prijavljuje tehničke signale koje je zaista uočila.
Zbog toga interfejs eksplicitno kaže:
Ovo ne potvrđuje stvarno indeksiranje u pretraživačima.
Zašto Fridica jednostavno ne ocenjuje sve?
Zato što svaki tehnički detalj ne zaslužuje kazneni poen.
Na primer, odsustvo opcionalnog resursa ne bi automatski trebalo da smanji rezultat ako nema dokazanog tehničkog problema.
Fridica pokušava da razdvoji:
- korisne informacije;
- konkretna upozorenja;
- stvarne greške;
- provere koje nisu primenljive.
To pomaže da readiness score ostane vezan za uočljive probleme, umesto da se svaka preporuka pretvori u novo umanjenje ocene.
Šta treba prvo popraviti?
Ako Fridica prijavi više tehničkih problema, počnite od svega što može sprečiti željene stranice da budu dostupne ili pravilno razumljive.
Praktičan redosled može biti:
- Proverite nenamernu blokadu celog sajta.
- Proverite neočekivane
noindexdirektive. - Popravite neispravne ili nedostupne stranice.
- Proverite canonical probleme.
- Popravite neispravne sitemap resurse.
- Zatim rešavajte informativne nalaze nižeg prioriteta.
Tačan prioritet zavisi od nalaza u vašem auditu.
Zato Fridica prikazuje prioritetne preporuke umesto da svaki problem predstavlja kao jednako hitan.
Pitajte Fridicu kada tehnički jezik počne da nervira
Terminologija tehničkog SEO-a ume da bude nepotrebno zastrašujuća.
Ako vidite nešto kao:
Missing canonical URL
ili:
Declared sitemap unusable
ne morate prvo da naučite napamet tehnički priručnik da biste znali koji je sledeći korak.
Ask Fridica može da objasni nalaz u kontekstu vašeg konkretnog audita.
Možete postaviti pitanja kao što su:
- Šta treba prvo da popravim?
- Zašto je ovaj canonical problem važan?
- Da li je moj veb-sajt blokiran robots.txt fajlom?
- Šta znači noindex?
Odgovor se zasniva na nalazima koje je deterministički audit već proizveo.
Fridica objašnjava dokaze. Ne izmišlja ih.
Cilj tehničkog SEO-a
Tehnički SEO ne mora da postane takmičenje u skupljanju što većeg broja zelenih kvačica.
Korisniji cilj je:
Učinite javne stranice koje su vam važne dostupnim, jasno identifikovanim i tehnički razumljivim.
Fridica vam pomaže da vidite gde ti signali izgledaju zdravo, gde nešto zaslužuje pažnju i šta možete sledeće da proverite.
Nastavite da učite
Povezani vodiči za temu Technical SEO
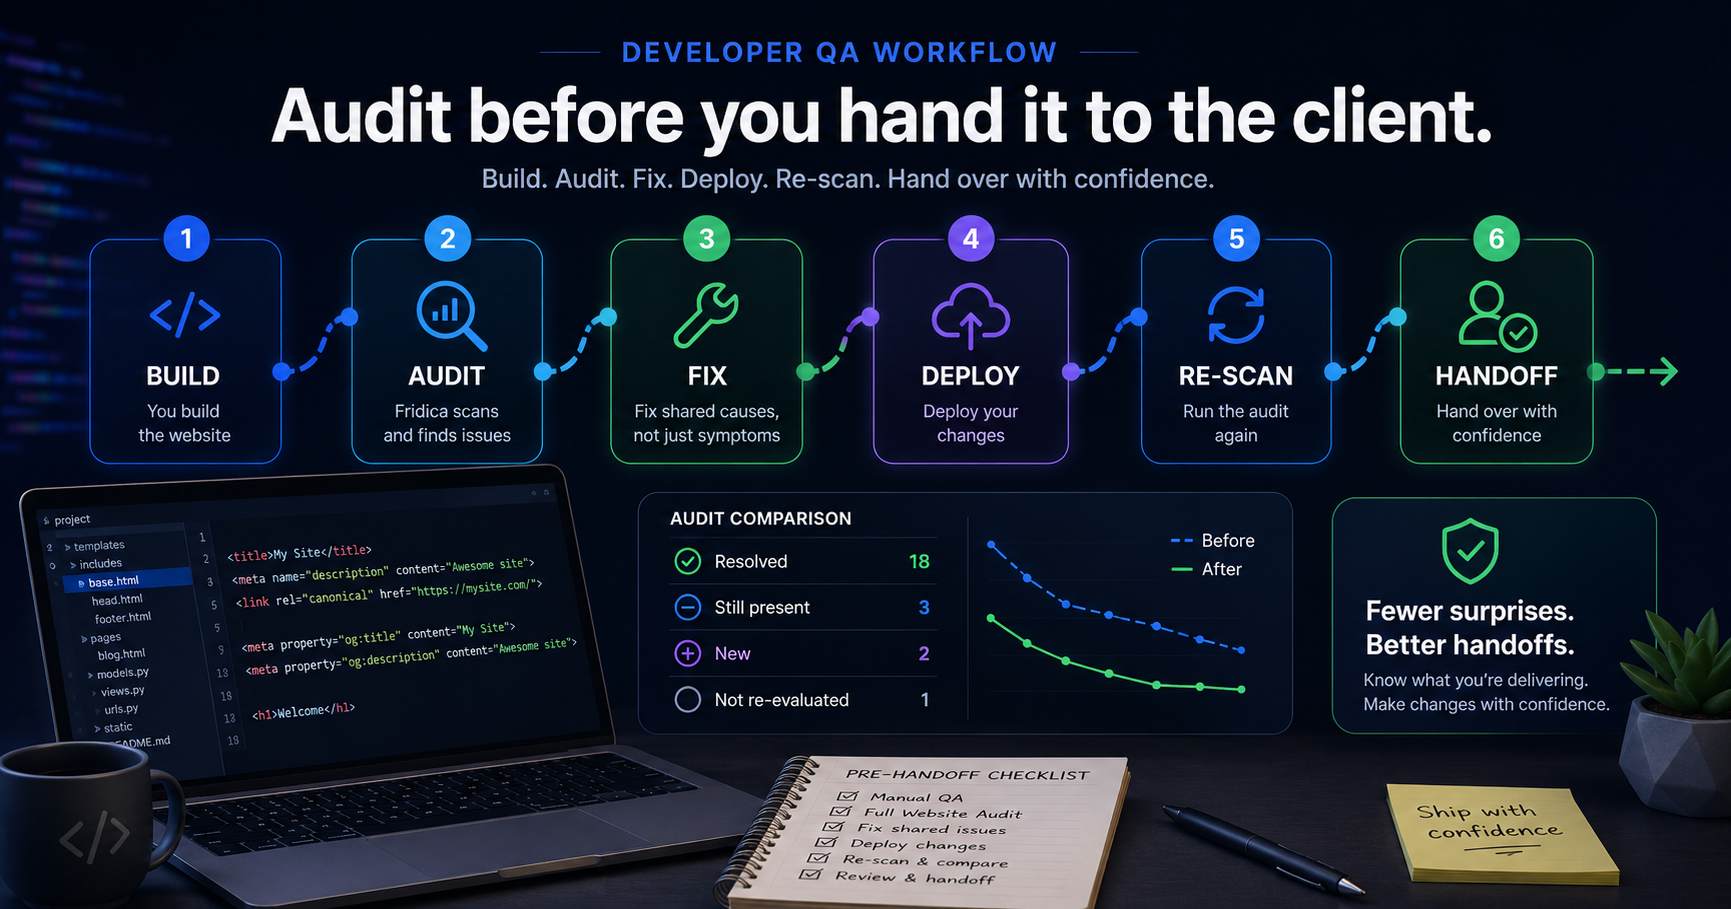
Fridica za developere: audit pre nego što predate sajt klijentu
Sajt može izgledati potpuno završen, a da i dalje ima tehničke i strukturne SEO probleme. Saznajte kako developeri mogu koristiti Fridicu kao dodatni QA korak pre predaje sajta klijentu.
Pročitajte vodičSprovedite ovo u praksi
Pogledajte šta se odnosi na vašu stranicu.
Počnite pregledom jedne stranice, a zatim pokrenite analizu celog veb-sajta kada budete spremni.